Claude Opus 5.5: prestazioni da Fable 5.1, costi giù del 40%
Il primo modello della famiglia 5.5 guida Terminal-Bench 4.0, scrive più chiaro e scende a 4/20 dollari per milione di token. Con le salvaguardie dei modelli di frontiera e quattro breaking change per chi lo usa via API.
In sintesi
Claude Opus 5.5 è il primo modello della famiglia 5.5 di Anthropic: sulla maggior parte dei lavori rende come Fable 5.1 e costa circa il 40% in meno di Opus 5. • Listino a 4/20 $ per milione di token (−20%), cache read a 0,20 $ (−60%), output oltre il 30% più veloce. • Guida Terminal-Bench 4.0 (66,4%), CursorBench (57,8%) e GDPval-AA (1846 Elo); GPT-6 Astra resta avanti su Terminal-Bench-Science e AutomationBench. • A sforzo medio raggiunge o supera i migliori punteggi OpenAI spendendo da un quinto a due quinti per task. • Miglior audit di allineamento Anthropic, ma la system card segnala regressioni su istruzioni malevole incollate nel prompt. • Via API: thinking sempre attivo, niente tool use forzato, sforzo predefinito medium.
Anthropic ha rilasciato oggi, 22 settembre 2026, Claude Opus 5.5: sulla maggior parte dei lavori rende come Claude Fable 5.1, il modello di punta presentato tre settimane fa, e con le impostazioni predefinite costa circa il 40% in meno di Opus 5. È il primo modello della nuova famiglia Claude 5.5: Sonnet 5.5 e Haiku 5.5 arriveranno nelle prossime settimane, con gli stessi miglioramenti su prestazioni, efficienza e sicurezza.
La notizia non è solo un punteggio più alto. Opus 5.5 guida Terminal-Bench 4.0, CursorBench e le classifiche di lavoro professionale di Artificial Analysis, ma il dato che pesa di più per chi lo mette in produzione è un altro: a sforzo medio, il livello predefinito, raggiunge o supera i punteggi massimi dei modelli OpenAI spendendo da circa un quinto a circa due quinti per task. È anche il primo rilascio di Anthropic dopo l'appello di Dario Amodei a «rallentare la frontiera», ed esce con le salvaguardie finora riservate ai modelli più potenti.
Claude Opus 5.5 in breve
- Prezzo: 4 $ per milione di token in input e 20 $ in output, il 20% in meno di Opus 5. Le letture dalla cache scendono a 0,20 $ (−60%).
- Costo reale: secondo Anthropic, sui carichi tipici e con le impostazioni predefinite, circa il 40% in meno di Opus 5, perché costa meno per token e usa meno token per task.
- Velocità: genera output oltre il 30% più rapidamente di Opus 5; la modalità fast arriva fino a 2,5 volte.
- Contesto: 1 milione di token, output fino a 128.000 token (300.000 in batch, in beta).
- Ragionamento: thinking adattivo sempre attivo, regolato dal parametro effort. Il livello predefinito è medium.
- Sicurezza: miglior risultato di sempre sull'audit comportamentale di Anthropic, testato prima del rilascio da METR e Frontier Design.
| Voce | Dato ufficiale al 22 settembre 2026 |
|---|---|
| ID API | claude-opus-5-5 (Bedrock: anthropic.claude-opus-5-5) |
| Contesto / output | 1M token / 128K token |
| Input → output | Testo e immagini → testo |
| Prezzo base | 4 $ input / 20 $ output per milione di token |
| Cache | Lettura 0,20 $ · scrittura 5 minuti 5 $ · scrittura 1 ora 8 $ |
| Batch | Metà prezzo: 2 $ / 10 $ |
| Fast mode | 8 $ / 40 $, fino a 2,5 volte più veloce (API Claude e Claude Code) |
| Sforzo predefinito | medium (su Opus 5 era high) |
| Conoscenza affidabile fino a | Giugno 2026 |
| Disponibilità | API Claude, Amazon Bedrock, Claude Platform on AWS, Google Cloud, Microsoft Foundry |
| Ritiro | Non prima del 22 settembre 2027 |
Dove Opus 5.5 guida e dove no
Sui sei benchmark per cui esiste un valore di tutti e quattro i modelli di punta, Opus 5.5 vince in quattro. Il distacco più netto è su Terminal-Bench 4.0, che misura lavori professionali in più passaggi dentro un terminale: 66,4% contro il 57,9% di GPT-6 Astra e il 55,8% di Fable 5.1. Su FrontierCode, che valuta se le modifiche al codice di un agente verrebbero accettate in un progetto reale, il margine su Astra si riduce a un punto.
GPT-6 Astra resta davanti in due casi: la ricerca scientifica agentica di Terminal-Bench-Science (64,6% contro 58,7%) e i workflow aziendali di AutomationBench (41,4% contro 40,0%). Su quest'ultimo pesa un dettaglio: Zapier ha eseguito il test senza modelli di riserva, quindi ogni intervento delle salvaguardie di Anthropic è stato contato come errore.
La stessa Anthropic invita a leggere questi margini con prudenza: a questo livello di capacità, scrive, le differenze nei benchmark sono una guida meno affidabile di quelle nel lavoro vero, e nell'uso interno la distanza tra Opus 5.5 e Fable 5.1 è più stretta di quanto dicano i numeri. C'è anche un effetto che gioca contro Opus 5.5: è stato valutato con le salvaguardie di produzione accese, e quando intervenivano il task passava a un altro modello (Opus 4.8 per la cybersecurity, Opus 5 per biologia e sviluppo di LLM).
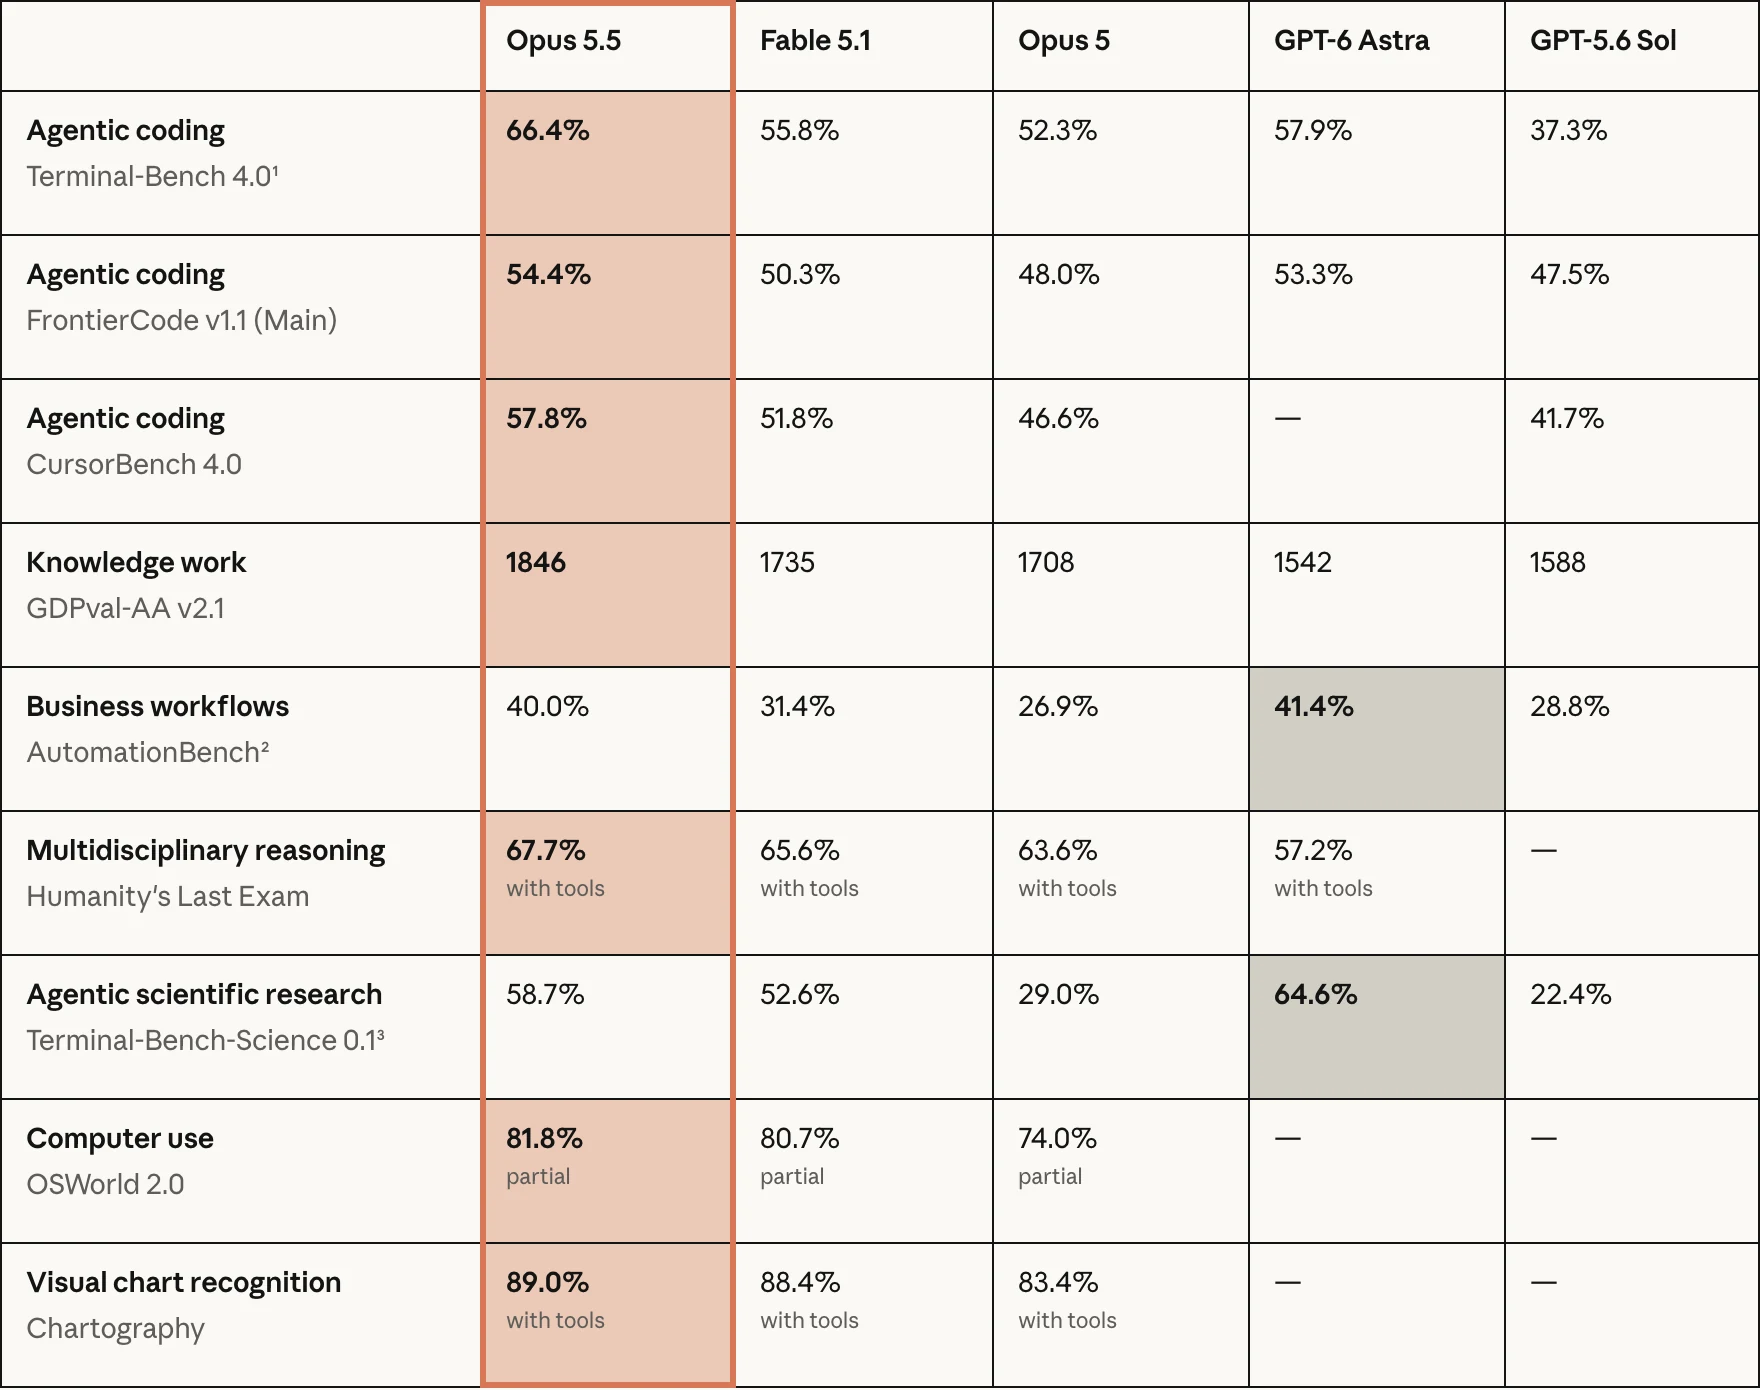
Qui sotto la stessa tabella in versione completa, con i benchmark aggiuntivi della system card (SWE-bench, HLE senza strumenti, HealthBench, AA-Briefcase).
| Benchmark | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 66,4% | 55,8% | 52,3% | 57,9% | 37,3% |
| FrontierCode v1.1 (Main) | 54,4% | 50,3% | 48,0% | 53,3% | 47,5% |
| CursorBench 4.0 | 57,8% | 51,8% | 46,6% | — | 41,7% |
| SWE-bench Pro | 89,9% | 81,2% | 79,2% | — | — |
| SWE-bench Multilingual | 93,9% | 89,1% | 89,5% | — | — |
| SWE-bench Multimodal | 61,4% | 54,7% | 59,4% | — | — |
| Terminal-Bench-Science 0.1 | 58,7% | 52,6% | 29,0% | 64,6% | 22,4% |
| Humanity's Last Exam (senza strumenti) | 64,4% | 60,9% | 56,6% | — | — |
| Humanity's Last Exam (con strumenti) | 67,7% | 65,6% | 63,6% | 57,2% | — |
| OSWorld 2.0 (partial / strict) | 81,8% / 48,7% | 80,7% / 42,8% | 74,0% / 37,2% | — | — |
| Chartography (con strumenti) | 89,0% | 88,4% | 83,4% | — | — |
| HealthBench Professional | 65,6% | 62,1% | 59,8% | 63,4% | — |
| GDPval-AA v2.1 (Elo) | 1846 | 1735 | 1708 | 1542 | 1588 |
| AA-Briefcase v1.1 (Elo) | 1822 | 1678 | 1673 | 1569 | — |
| AutomationBench | 40,0% | 31,4% | 26,9% | 41,4% | 28,8% |
Il salto rispetto a Opus 5
Il confronto con il predecessore è quello che interessa a chi usa già Claude in produzione. Opus 5.5 migliora su ogni benchmark della tabella riassuntiva della system card, e i guadagni più ampi stanno dove un agente passa più tempo: +10,7 punti su SWE-bench Pro, +11,2 su CursorBench (task ambigui su più file presi da sessioni reali di Cursor), +11,5 su OSWorld 2.0 in modalità strict, cioè l'uso del computer giudicato senza crediti parziali. Su Terminal-Bench-Science il punteggio raddoppia, da 29,0% a 58,7%.
La lettura del grafico è semplice: in ogni riga Opus 5.5 supera anche Fable 5.1. Per il lavoro quotidiano di coding e computer use, pagare il listino di Fable 5.1 (10/50 $) diventa difficile da giustificare.
Quanto costa un buon risultato
Il listino racconta metà della storia. Rispetto a Opus 5 tutte le voci scendono, e la più importante per chi costruisce agenti è la lettura dalla cache, che secondo Anthropic rappresenta la maggior parte del costo nei lavori agentici e di coding.
| Prezzo per milione di token | Claude Opus 5.5 | Claude Opus 5 | Variazione |
|---|---|---|---|
| Lettura dalla cache | 0,20 $ | 0,50 $ | −60% |
| Input | 4 $ | 5 $ | −20% |
| Output | 20 $ | 25 $ | −20% |
| Scrittura in cache (5 minuti) | 5 $ | 6,25 $ | −20% |
L'altra metà è quanti token servono per arrivare al risultato. Anthropic ha pubblicato, per ogni benchmark, la curva che lega il punteggio al costo per task a ciascun livello di sforzo. Il confronto più utile è tra Opus 5.5 al livello predefinito e il miglior punteggio ottenuto dal rivale OpenAI, a qualunque livello.
Stesso punteggio, una frazione della spesa
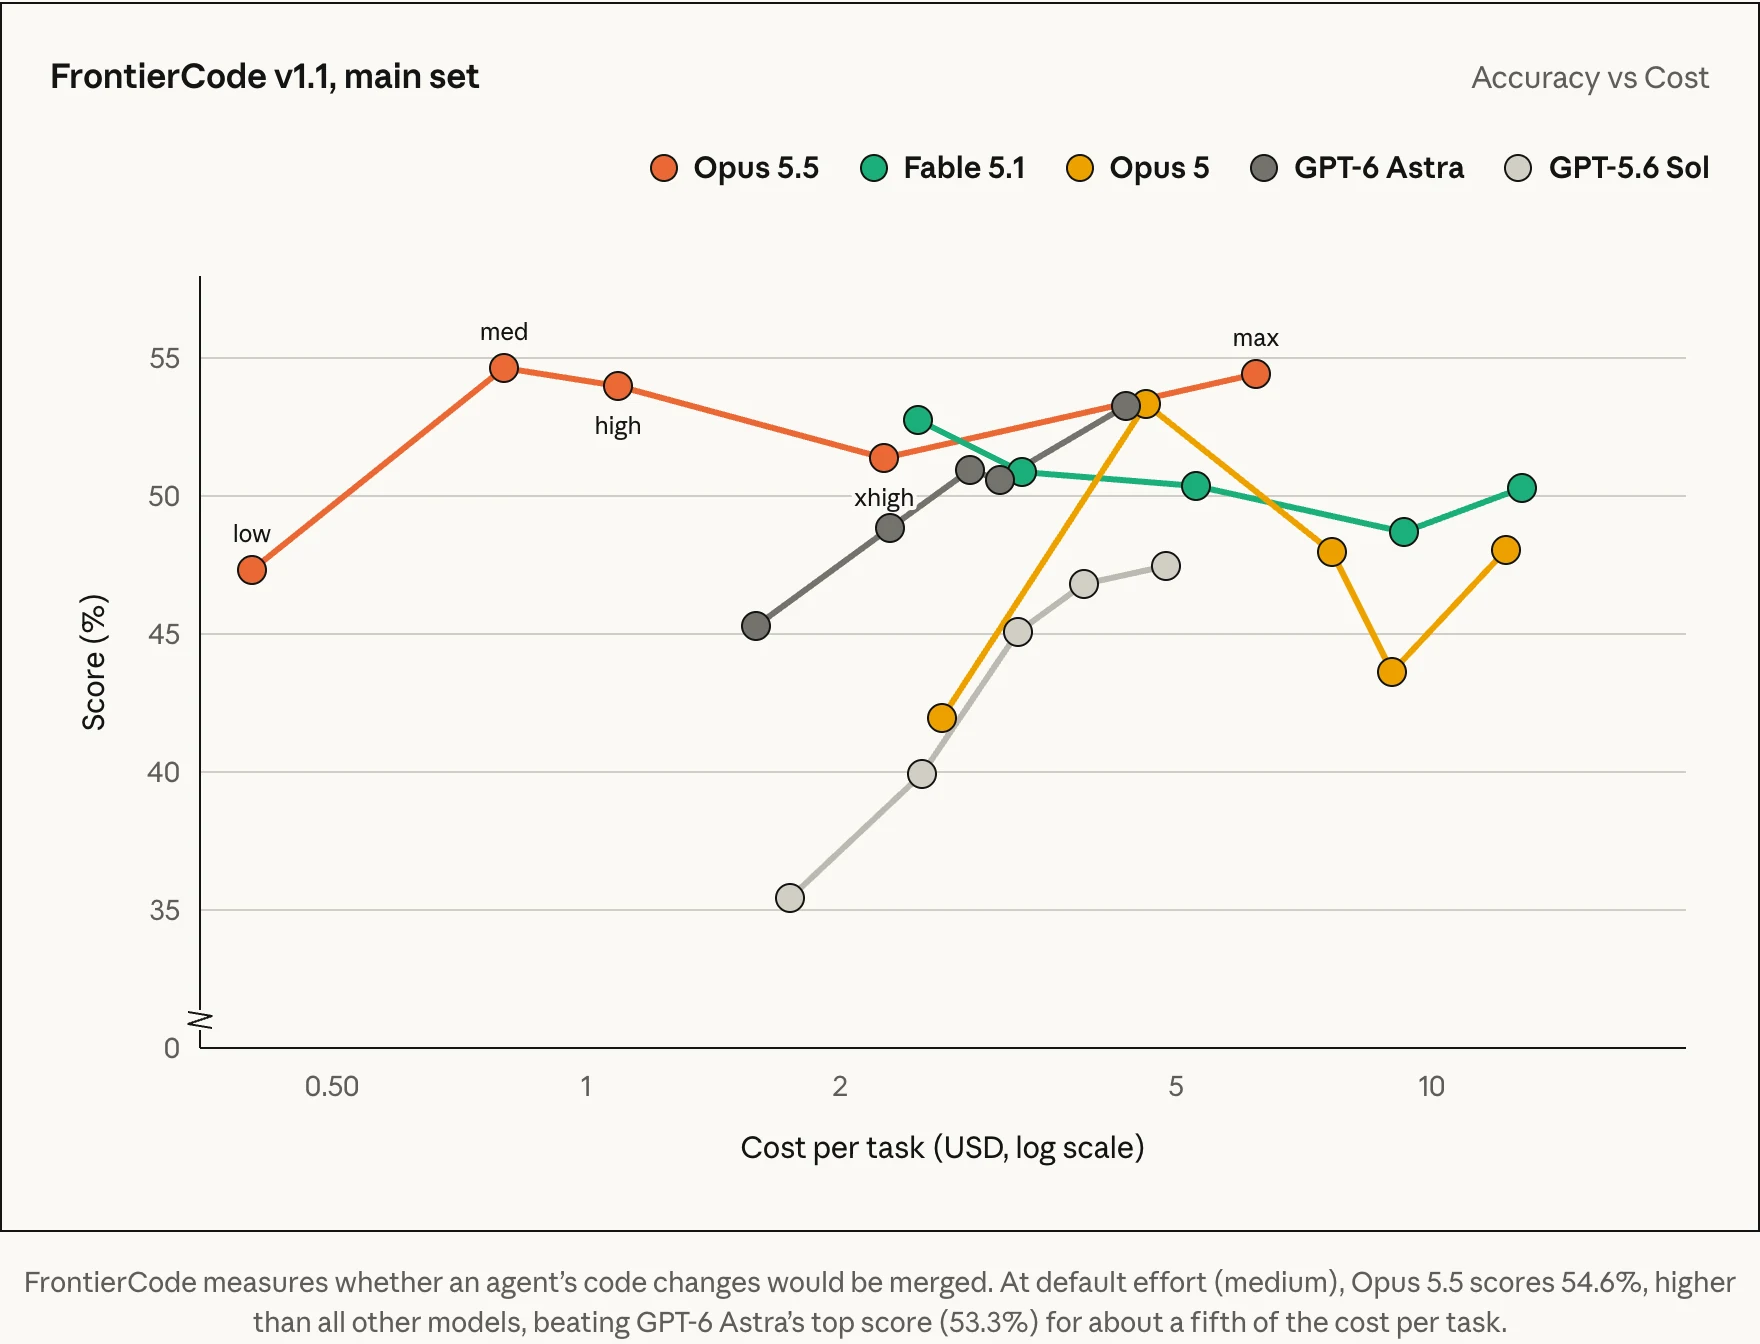
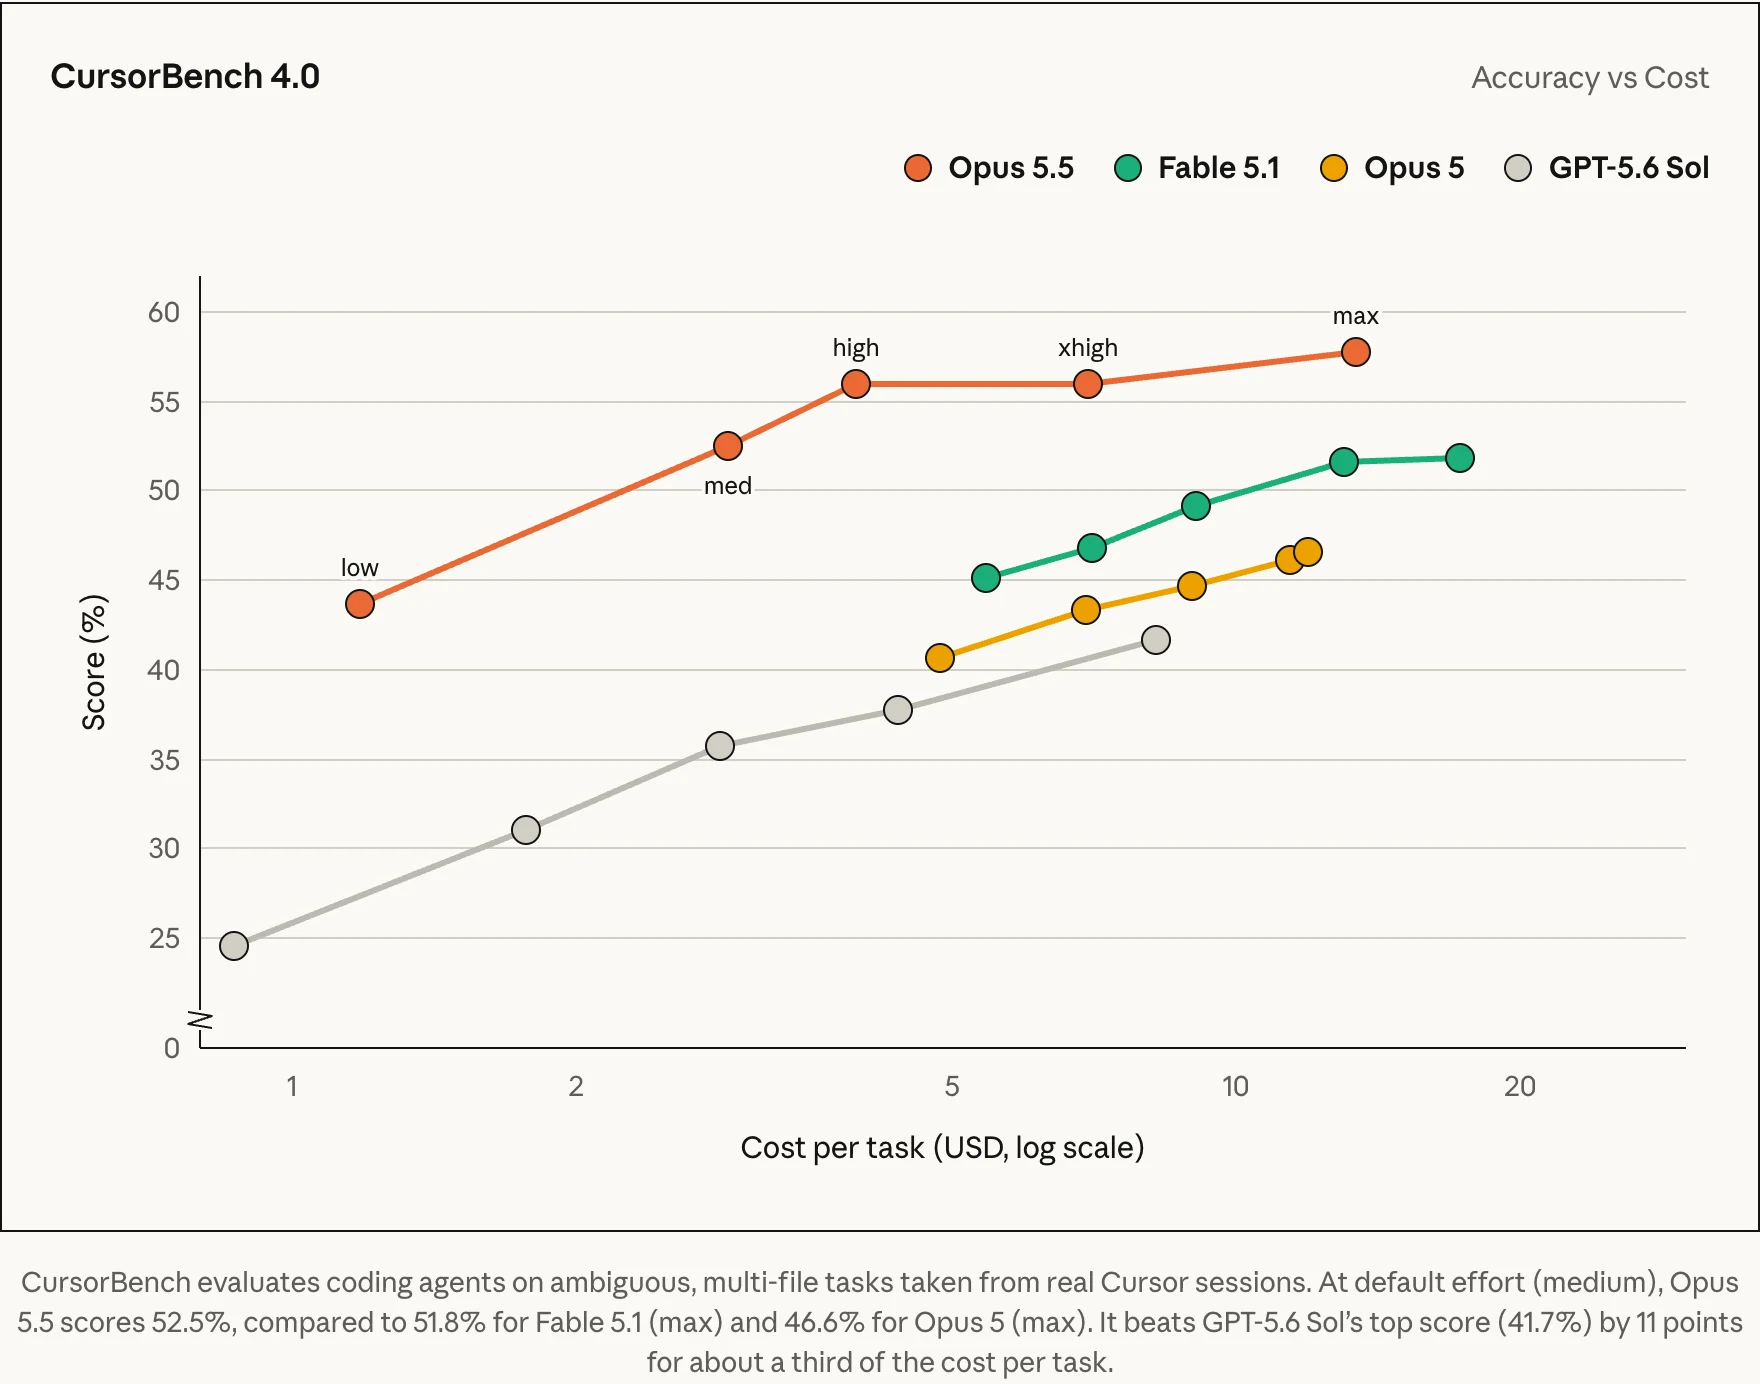
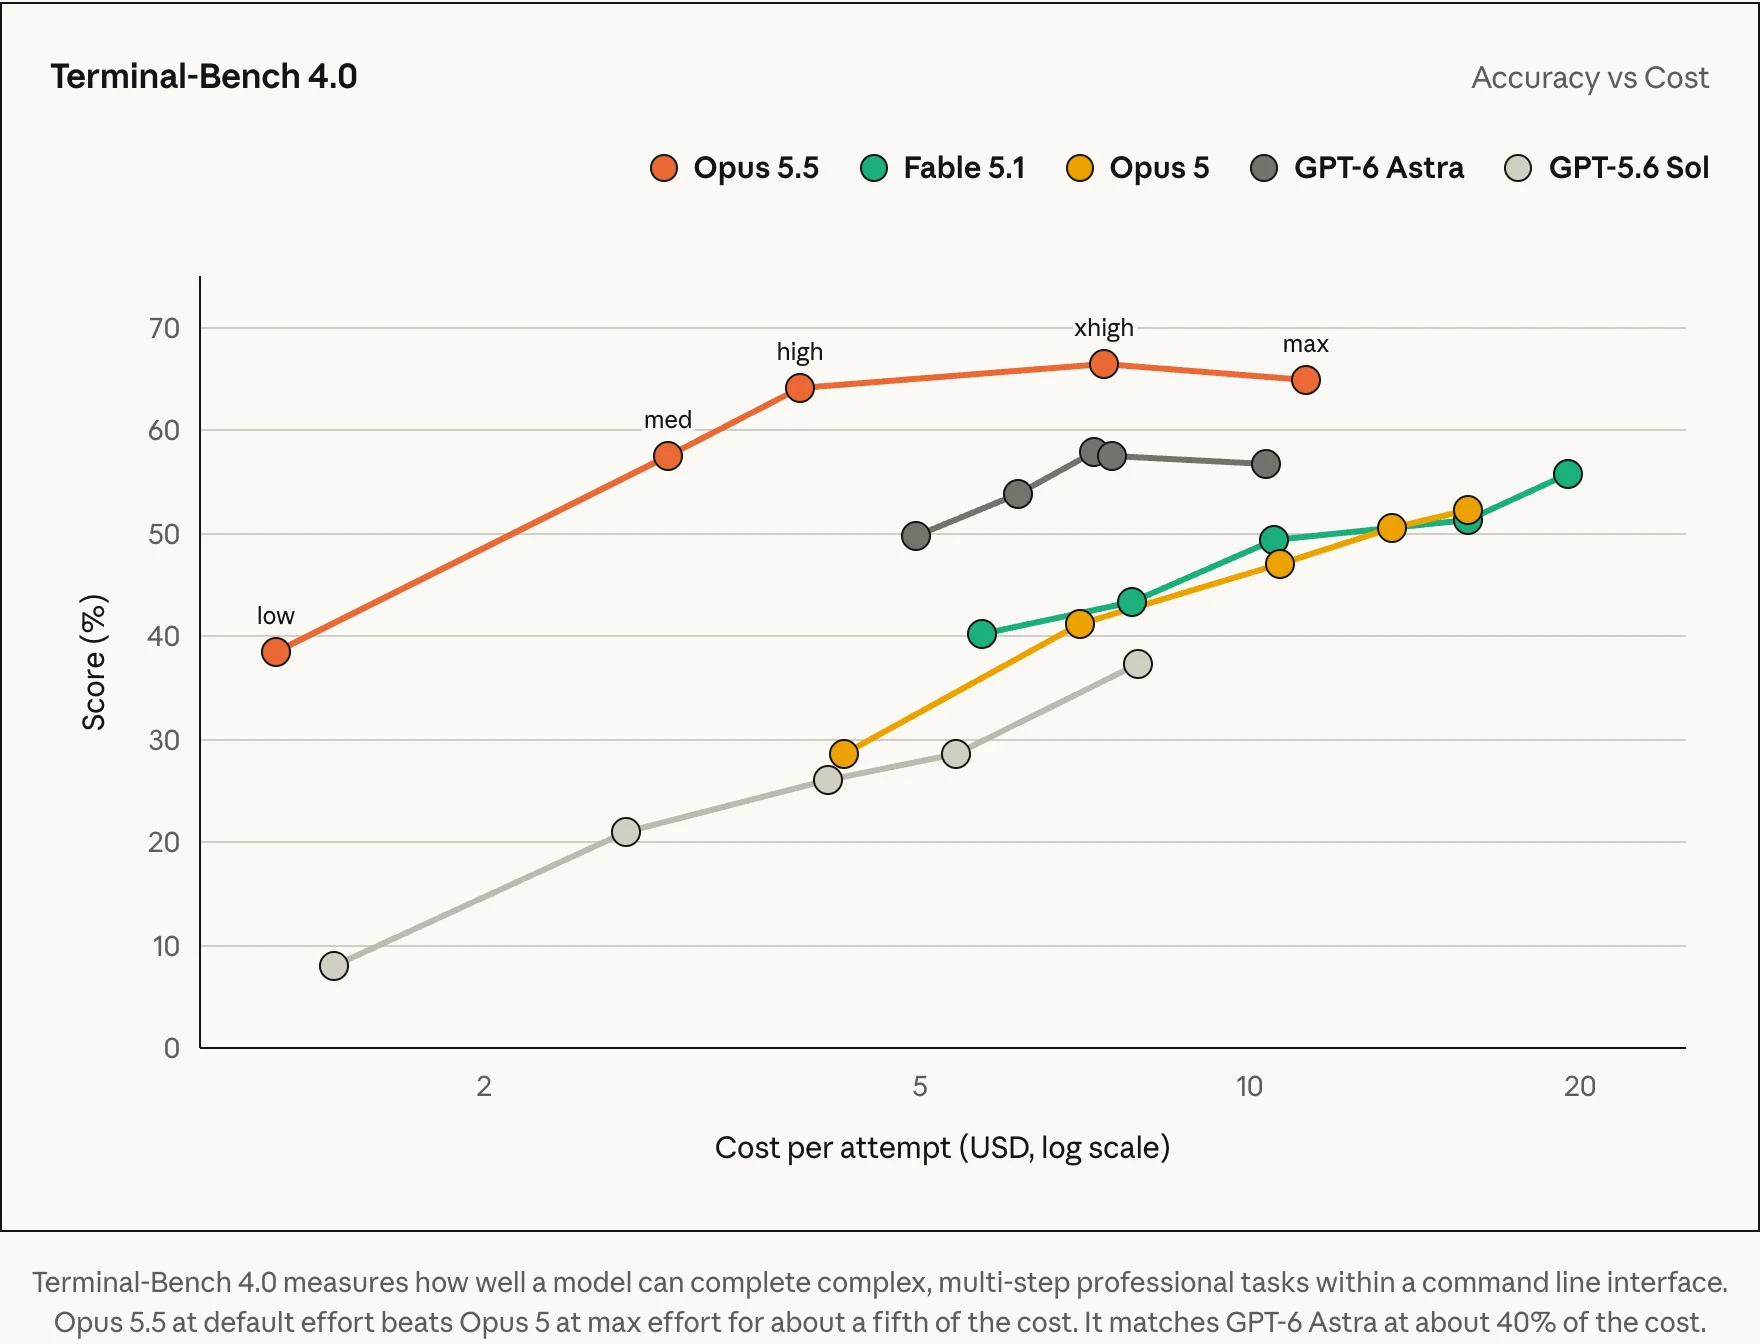
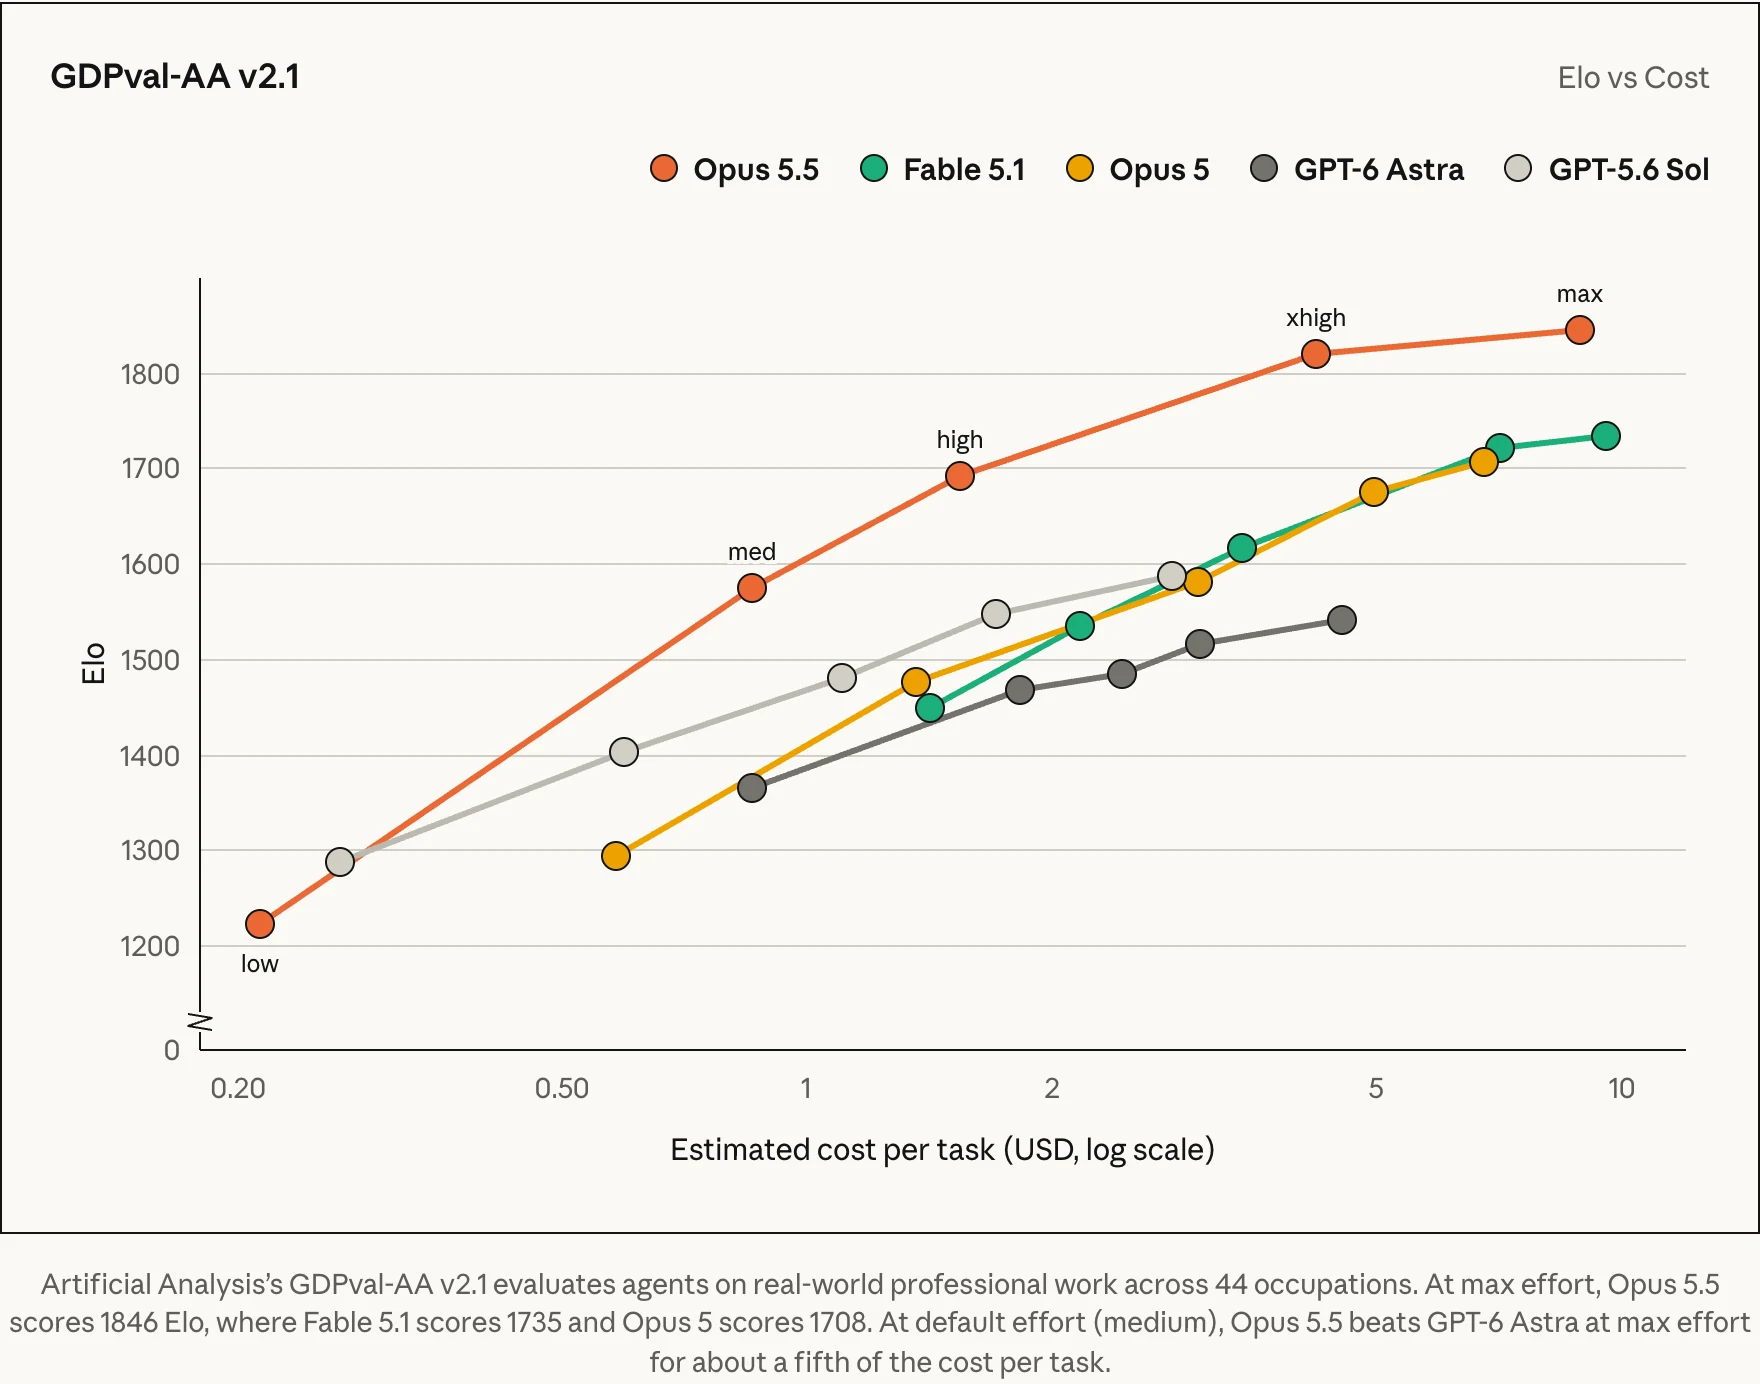
Su FrontierCode Opus 5.5 a sforzo medio segna il 54,6% spendendo circa 0,80 $ per task; GPT-6 Astra arriva al suo massimo, 53,3%, con circa 4,36 $. Su GDPval-AA il rapporto è simile: 1576 Elo contro 1542, con una spesa per task di circa un quinto. Su Terminal-Bench 4.0 Opus 5.5 non supera Astra ma lo pareggia (57,6% contro 57,9%) al 40% circa del costo, e su CursorBench batte il miglior GPT-5.6 Sol di 11 punti spendendo circa un terzo.
Il confronto interno è ancora più netto: su Terminal-Bench, Opus 5.5 a sforzo medio fa meglio di Opus 5 al massimo con circa un quinto della spesa.
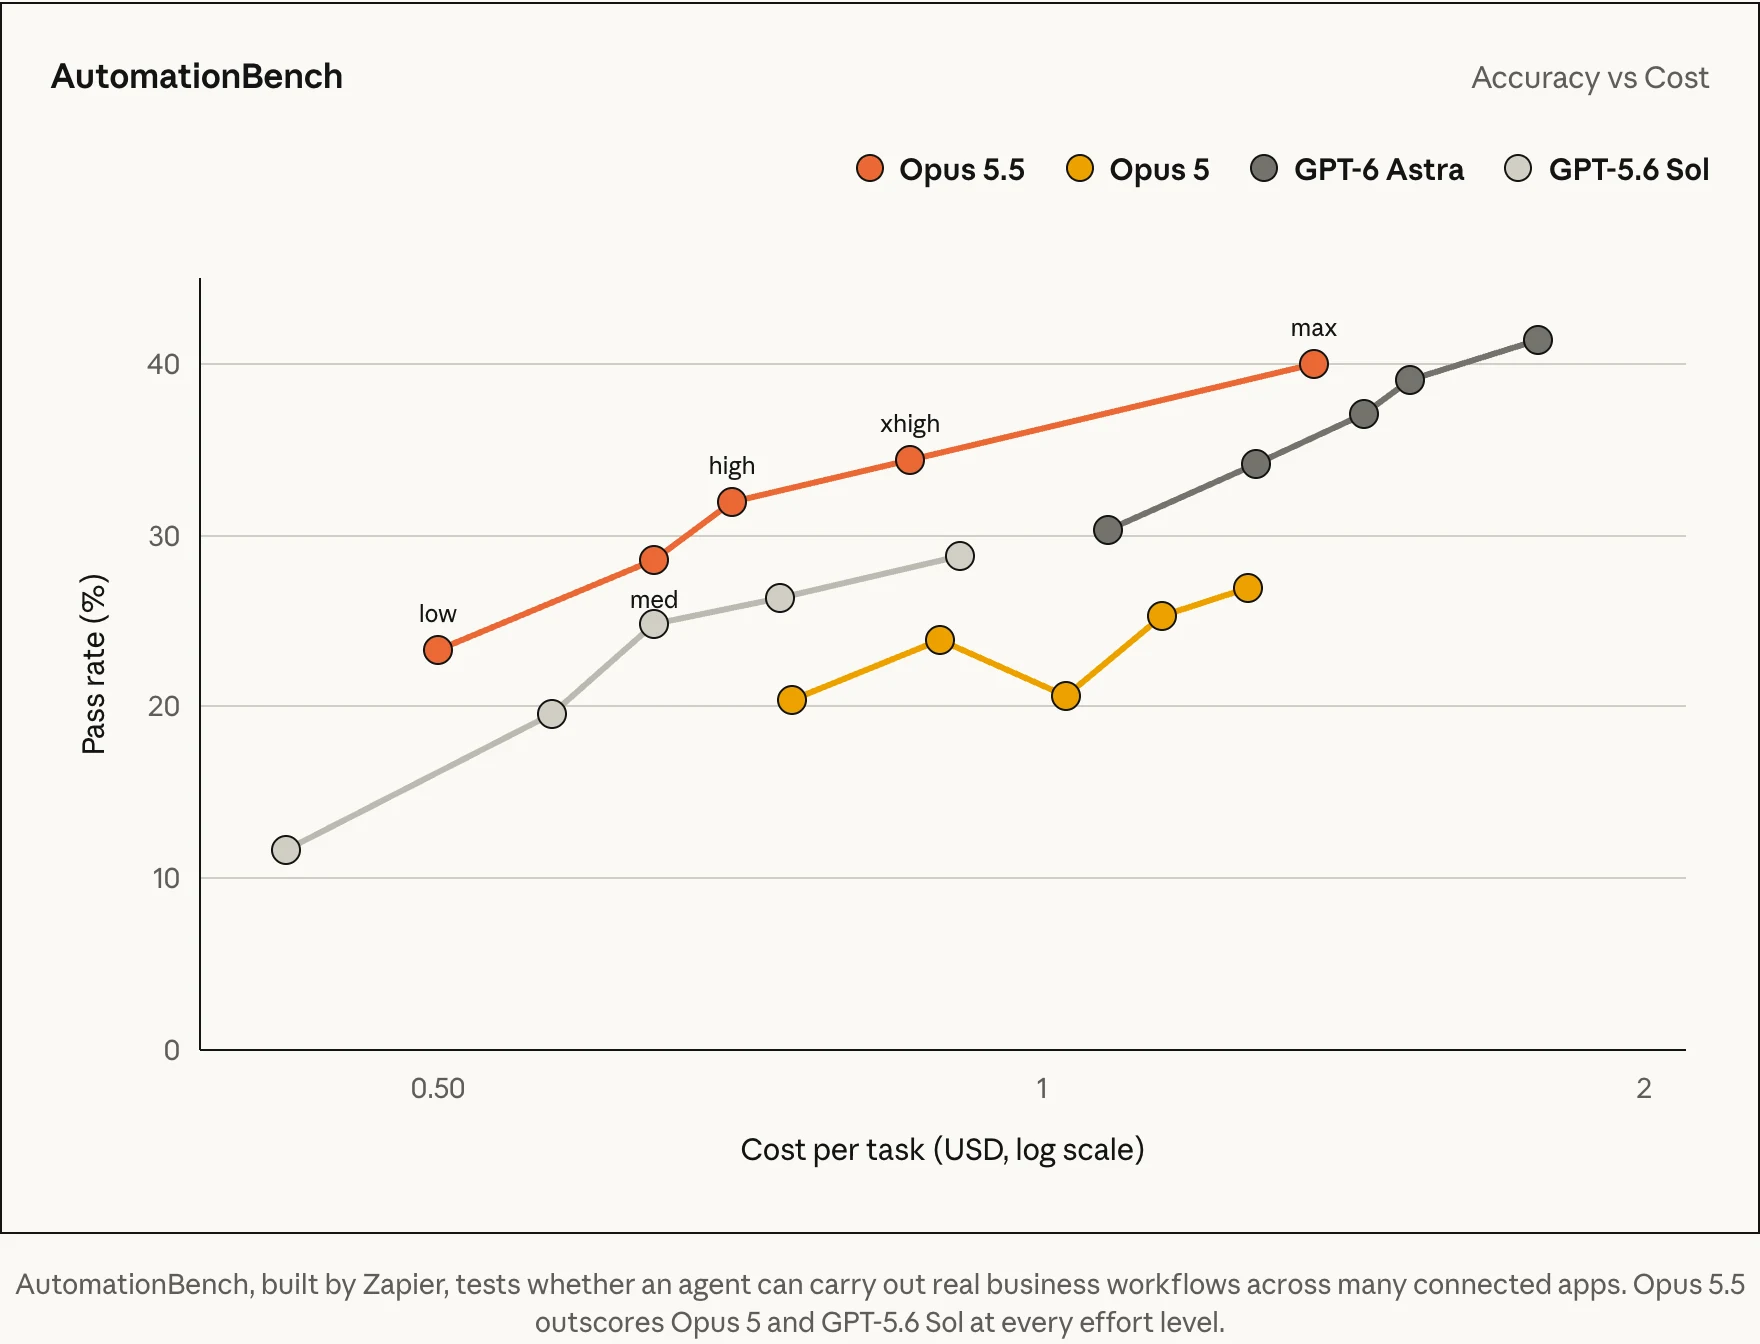
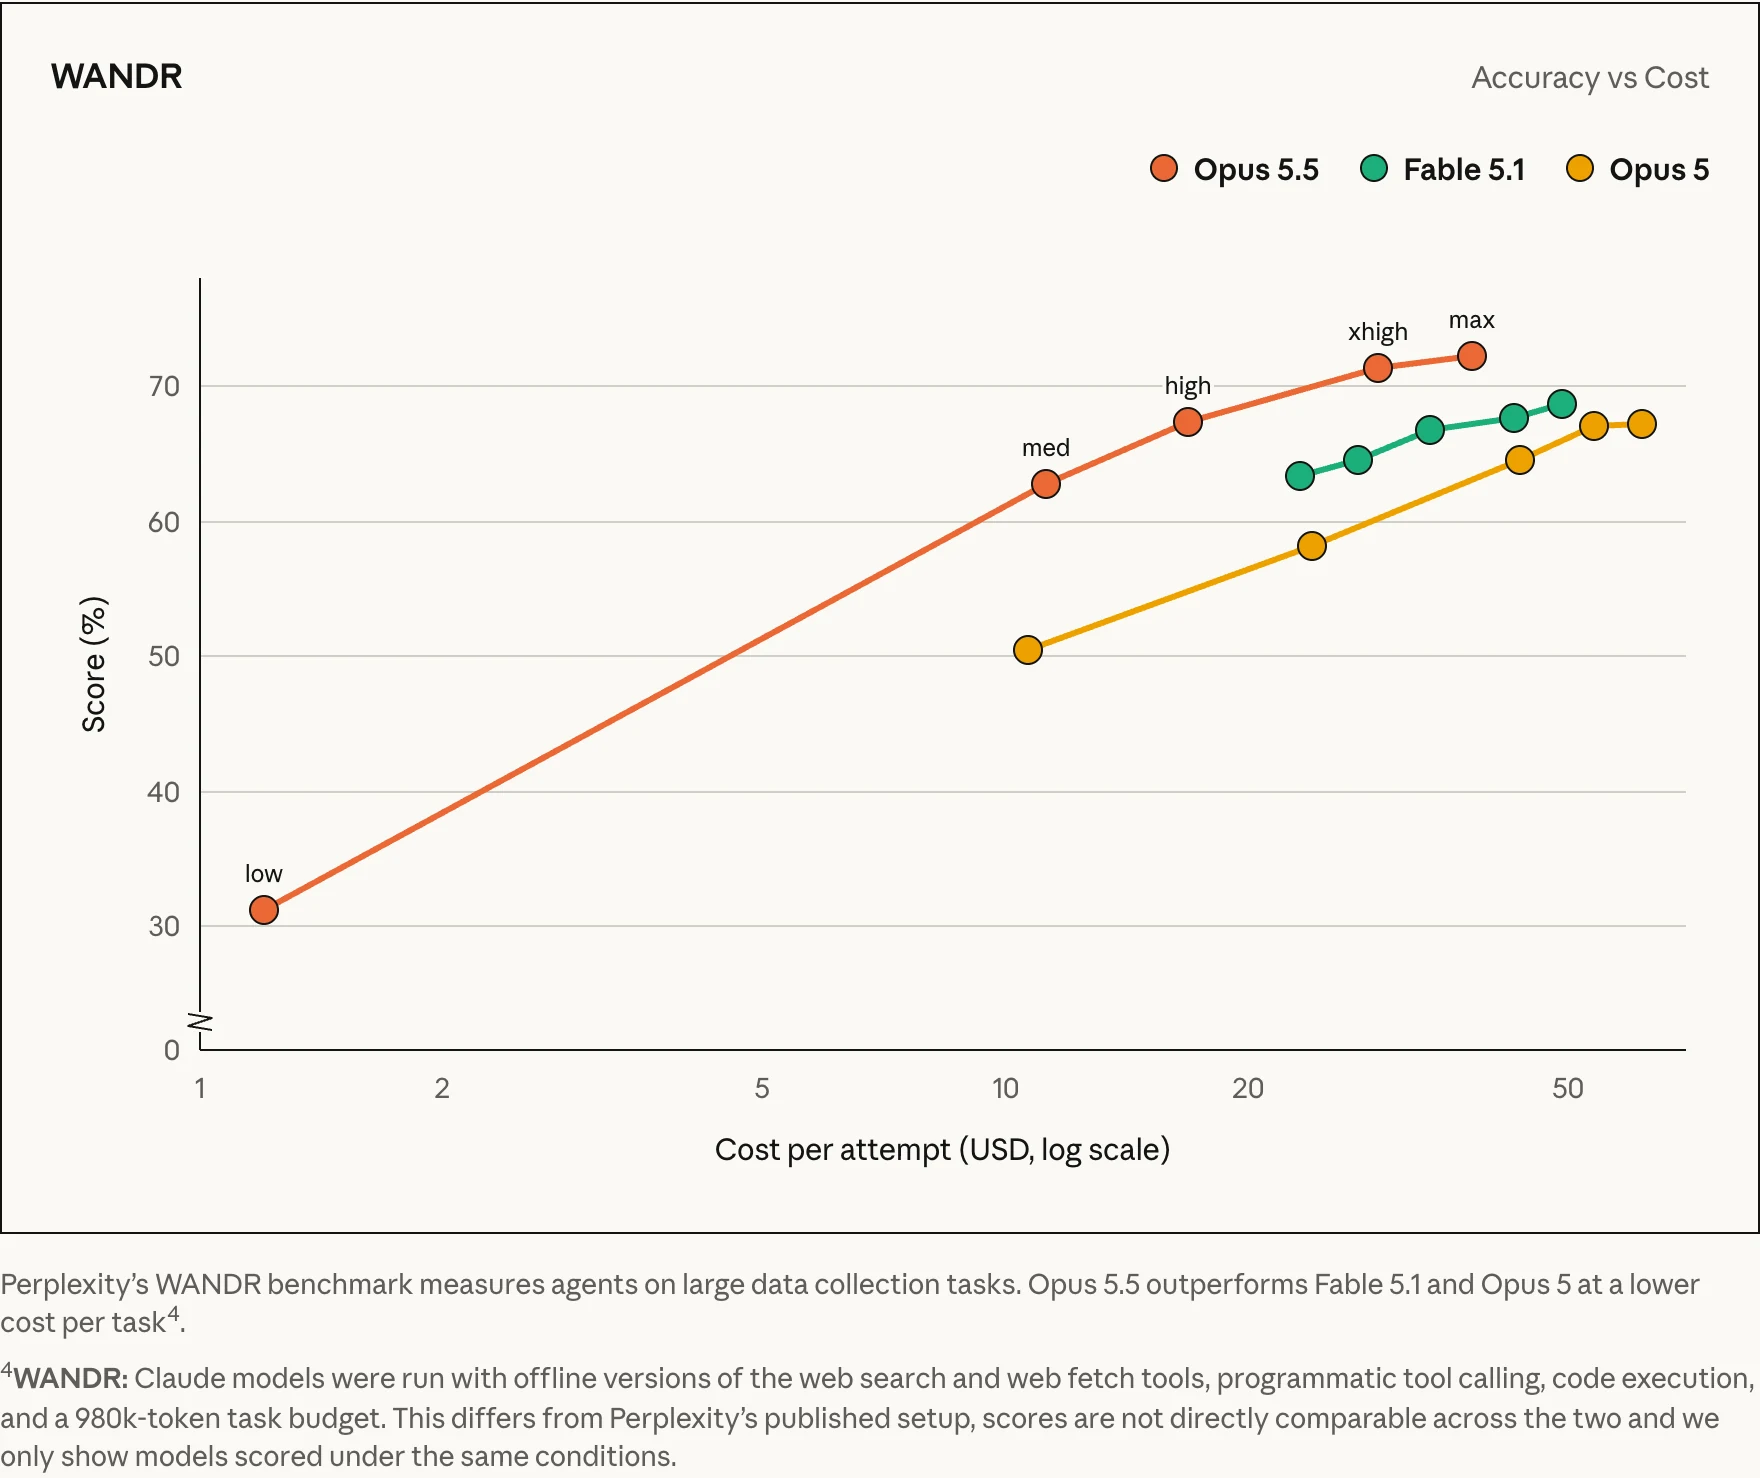
Questi sono i grafici originali di Anthropic da cui vengono i numeri: ogni punto è un livello di sforzo, da low a max, e l’asse orizzontale è il costo per task in scala logaritmica.
La curva dello sforzo su Terminal-Bench 4.0
Il grafico mostra il punteggio di ciascun modello ai cinque livelli di sforzo. Due dettagli meritano attenzione. Il primo: già a medium Opus 5.5 supera Fable 5.1 al massimo. Il secondo, meno ovvio: il livello max non è sempre il migliore. Su Terminal-Bench Opus 5.5 rende di più a xhigh (66,4%) che a max (64,8%), e max costa il 53% in più. Su FrontierCode medium (54,6%) supera max (54,4%) con circa un ottavo della spesa.
| Livello di sforzo | Terminal-Bench 4.0 | FrontierCode v1.1 | GDPval-AA v2.1 |
|---|---|---|---|
| low | 38,5% · 1,29 $ | 47,3% · 0,40 $ | 1224 · 0,21 $ |
| medium (predefinito) | 57,6% · 2,94 $ | 54,6% · 0,80 $ | 1576 · 0,86 $ |
| high | 64,2% · 3,88 $ | 54,0% · 1,09 $ | 1692 · 1,54 $ |
| xhigh | 66,4% · 7,35 $ | 51,4% · 2,25 $ | 1820 · 4,21 $ |
| max | 64,8% · 11,24 $ | 54,4% · 6,19 $ | 1846 · 8,92 $ |
Tradotto in pratica: prima di alzare lo sforzo "per sicurezza", conviene misurare. Sui lavori di coding il salto da medium a high è quasi sempre quello che rende di più per dollaro speso; il massimo ha senso soprattutto sul lavoro professionale lungo, dove la curva di GDPval continua a salire fino in cima.
Coding: migrazioni, audit e meno passaggi
Anthropic descrive Opus 5.5 come particolarmente adatto ai lavori lunghi e dispersivi, come le migrazioni e gli audit su intere codebase. Gli esempi pubblicati vanno in questa direzione:
- un tester ha completato una migrazione da 680.000 righe in meno di un giorno, lavoro stimato in settimane per un team;
- un altro ha fatto l'audit e la correzione di una codebase da 200.000 righe in meno di tre ore: Opus 5 ci aveva messo oltre 20 ore, usando 2,5 volte i token;
- nella traduzione interna di HAProxy da C a Rust, sia Opus 5.5 sia Fable 5.1 hanno superato quasi tutti i test di regressione del progetto, ma Opus 5.5 ha finito in 9 ore e mezza contro 12, con un costo inferiore del 51%;
- chiesto di ridurre i tempi di caricamento di ogni pagina di una web app, è riuscito 39 volte su 40, mentre Opus 5 otteneva miglioramenti minori e alterava il comportamento dell'app.
I clienti in accesso anticipato riportano soprattutto una cosa: meno passaggi per arrivare allo stesso risultato.
| Azienda | Cosa ha misurato |
|---|---|
| GitHub | Tra i modelli con meno token e passaggi misurati in Copilot CLI e VS Code; in VS Code risolve più task da terminale di Opus 5 in meno della metà dei passaggi. |
| Quantium | Un task complesso passato da 38 prompt in quattro giorni a 11 prompt in tre ore. |
| Optiver | Stessa qualità di Opus 5 in circa metà dei turni, del tempo e dei token di output: costo del carico ridotto del 40-50%. |
| Lovable | Build completate con un terzo-metà dei passaggi in meno e molti meno token. |
| Kiro | Più task risolti di Opus 5 con circa il 40% di chiamate in meno e metà dei token. |
| Clio | Un lavoro su sei repository lasciato girare di notte senza supervisione: oltre 18 ore in autonomia, meno rilavorazioni. |
| Stripe | Un rebase di 40 pull request impilate coordinato da una sessione che ne dirigeva una dozzina: tutte verdi in CI il pomeriggio dopo. |
| Factory | A sforzo medio pareggia Opus 5 a sforzo alto con il 20-25% di token di output in meno. |
Sul fronte sicurezza del codice, Anthropic lo presenta come il suo agente di coding più protetto: un classificatore esamina ogni azione prima che venga eseguita, la sandbox è open source e verificabile dai team di sicurezza, e la code review intercetta le vulnerabilità prima del merge. Contro la prompt injection il modello pareggia o batte Opus 5 in tutti i contesti testati, e sul benchmark di Gray Swan condivide con Fable 5.1 il tasso di successo degli attacchi più basso tra tutti i modelli testati.
Knowledge work: report senza cifre inventate
Il test interno più interessante riguarda la ricerca. Anthropic ha chiesto a Opus 5.5, Fable 5.1 e Opus 5 di scrivere un report sui risultati trimestrali di un'azienda usando solo ciò che trovavano su una copia del web in cui il comunicato sugli utili era difficile da individuare. Un correttore automatico ha verificato ogni cifra e ogni citazione, e bastava un solo dato inventato per bocciare il report: 16 report su 18 di Opus 5.5 hanno superato la soglia, nessuno degli altri due modelli ci è riuscito in alcun tentativo.
In un'analisi di fusione tra due società fittizie di software HR, con modello finanziario in Excel e presentazione per il management, Opus 5.5 e Opus 5 sono arrivati alle stesse conclusioni, ma il modello finanziario di Opus 5.5 era più completo e la presentazione più leggibile, mentre quello di Opus 5 conteneva piccoli errori; Opus 5.5 ci ha messo 63 minuti invece di 93, con un costo dimezzato.
Lavoro professionale misurato in Elo
Sulle due classifiche di Artificial Analysis che confrontano agenti su lavoro d'ufficio reale, Opus 5.5 apre un distacco ampio: 1846 Elo su GDPval-AA, che copre 44 professioni, e 1822 su AA-Briefcase. GPT-6 Astra, che su altri test agentici è vicino, qui resta sotto di 250-300 punti.
Sui workflow aziendali di AutomationBench, costruito da Zapier, Opus 5.5 supera Opus 5 e GPT-5.6 Sol a ogni livello di sforzo, mentre GPT-6 Astra resta leggermente sopra al massimo. Su WANDR, il benchmark di Perplexity sulla raccolta di grandi quantità di dati, batte Fable 5.1 e Opus 5 spendendo meno per task; Anthropic avverte che la sua configurazione è diversa da quella pubblicata da Perplexity, quindi i punteggi non sono confrontabili con la classifica ufficiale.
| Azienda | Cosa ha misurato |
|---|---|
| Deloitte Consulting | Allo sforzo più basso individua il 72% dei bug noti nelle code review, contro il 56% di Opus 5 a sforzo alto, con meno falsi allarmi. |
| Hebbia | Sui workflow finanziari end-to-end copre l'86,6% dei criteri degli esperti, contro il 60,3% di Opus 5. |
| Rogo | Allo sforzo più basso batte Opus 5 a sforzo alto sul BigFinance Bench con circa il 60% di token di output in meno. |
| Box | Un terzo dei token di Opus 5 e risposte meno prolisse del 40%, senza perdere accuratezza. |
| Walleye Capital | Agli sforzi più alti ha notato che nelle istruzioni del test l'indicizzazione dei minuti era sfasata di uno e ne ha tenuto conto: nessun modello lo aveva fatto prima. |
| Viktor | A parità di sforzo, meno passaggi e chiamate, costo quasi dimezzato e il doppio dei task più difficili risolti. |
Scrive meno «alla Claude»
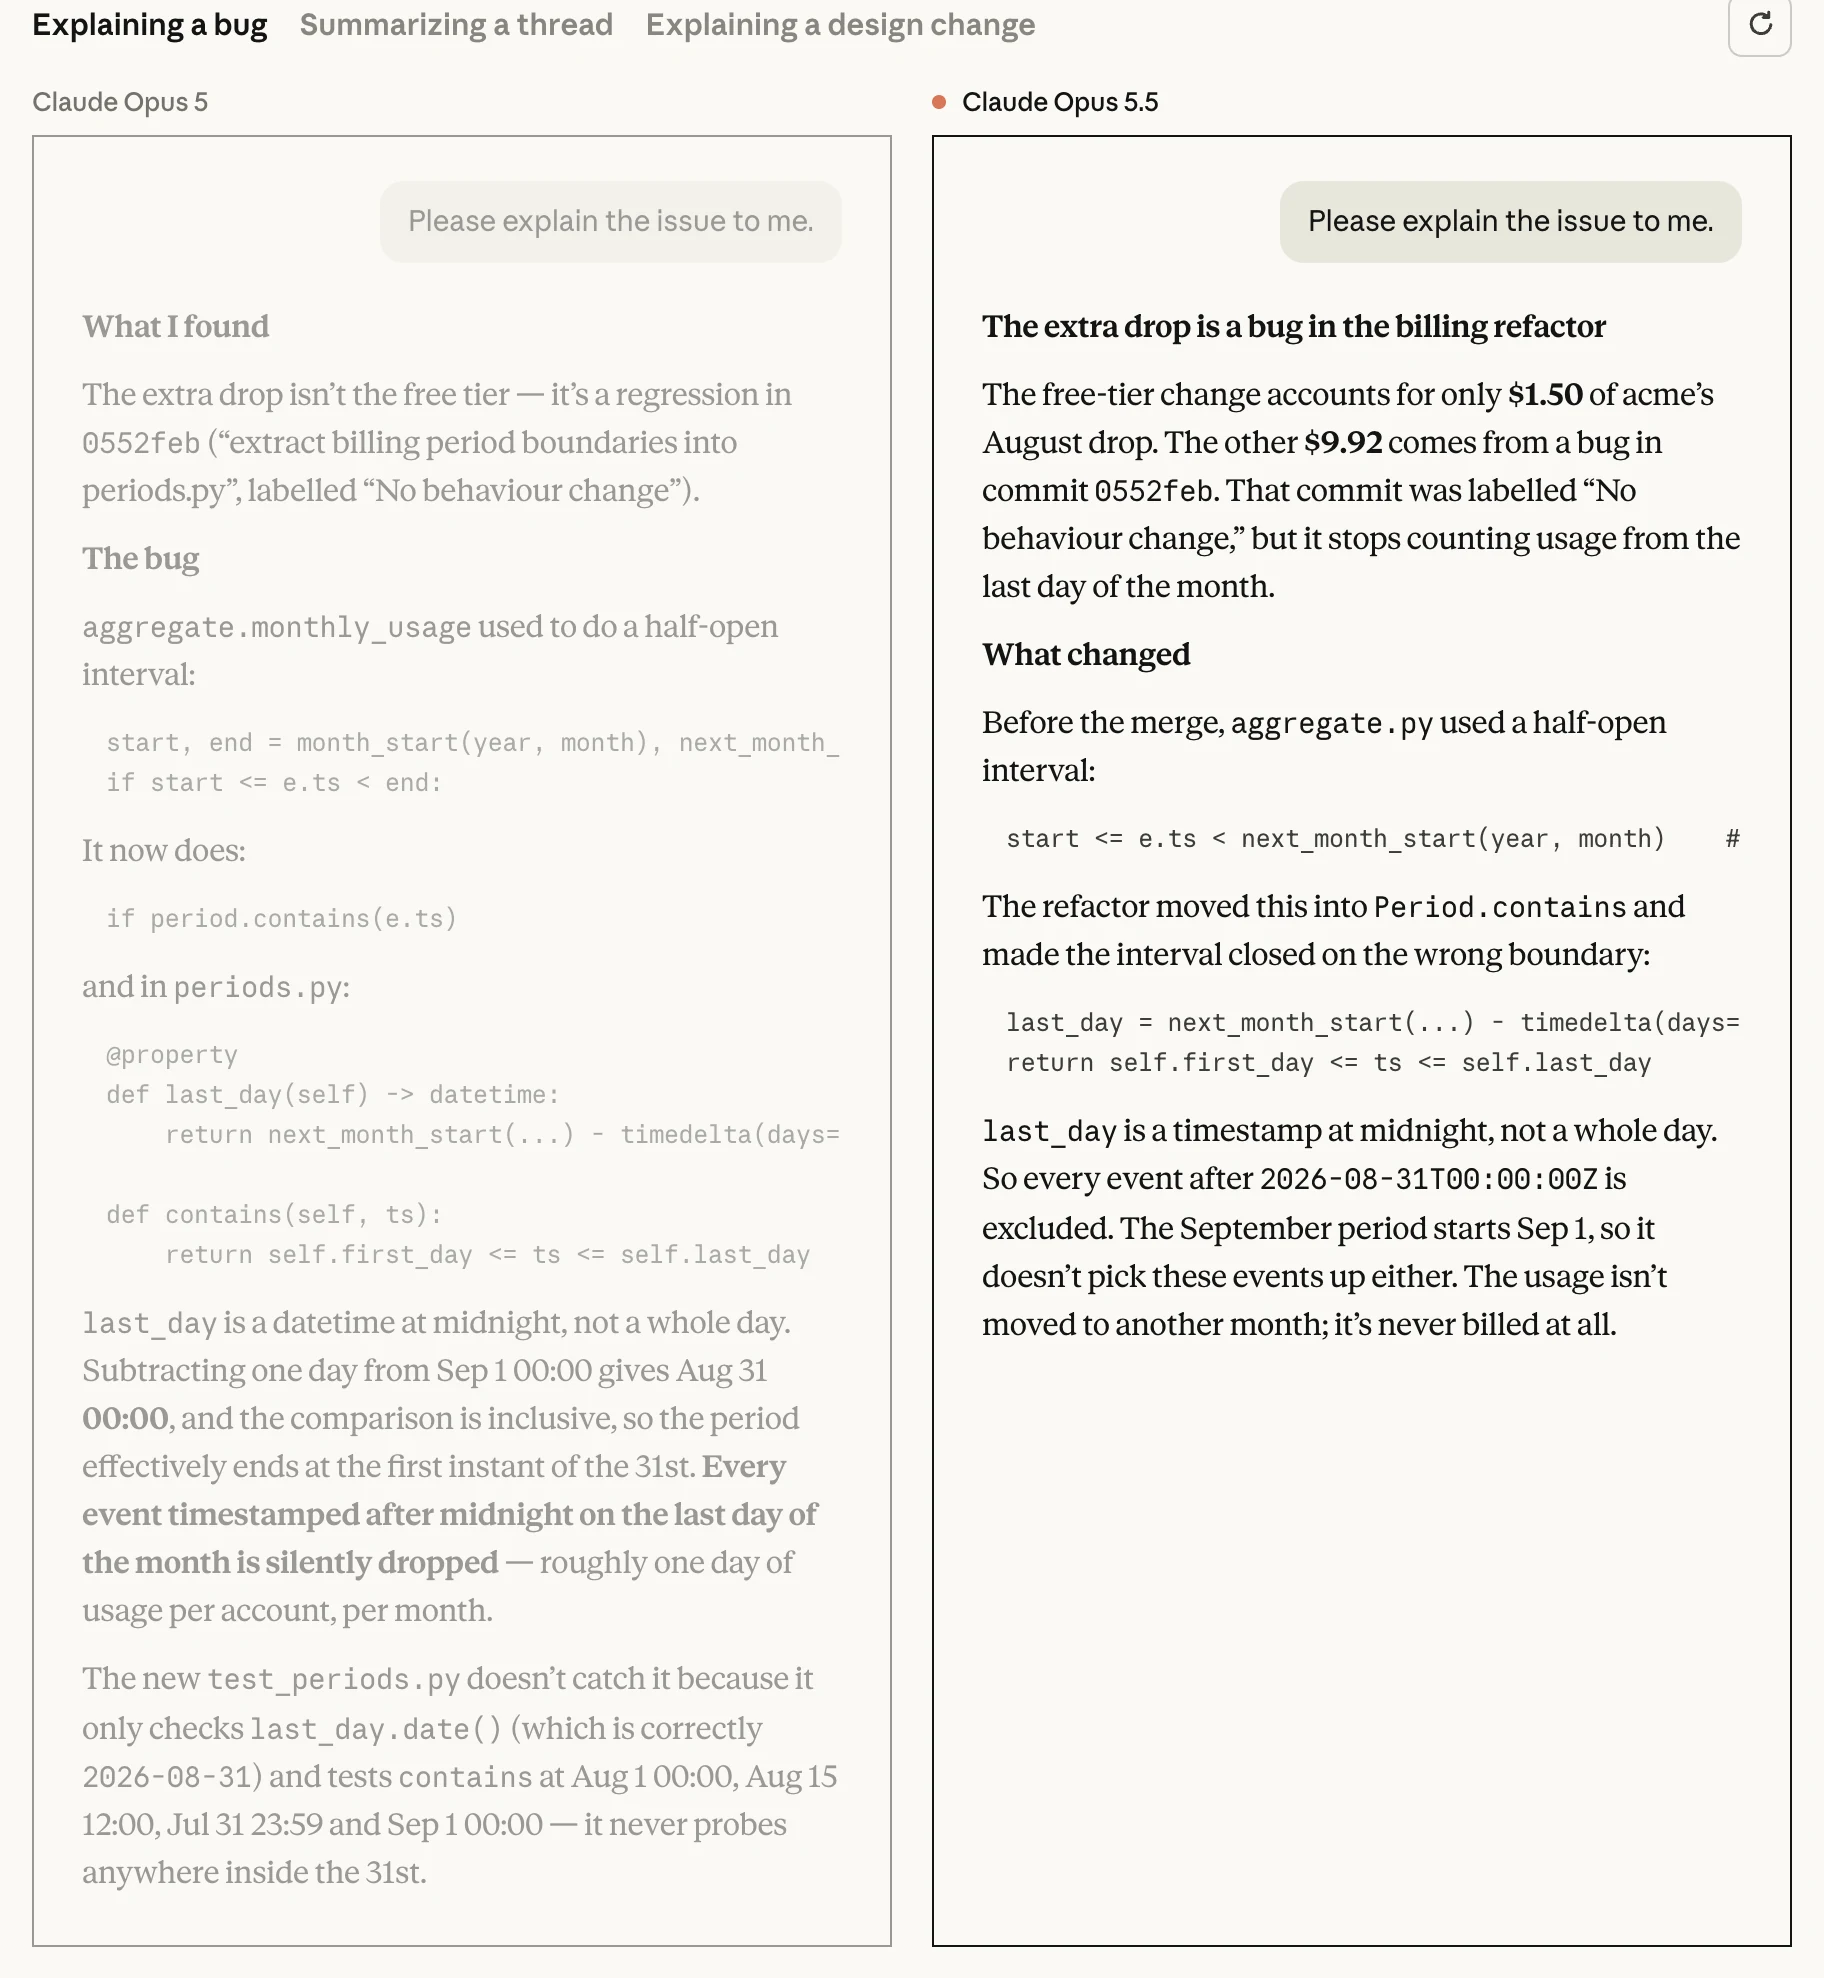
Una delle critiche più frequenti a Opus 5 riguardava la scrittura: messaggi lunghi, gergo, frasi idiosincratiche. Anthropic dichiara di aver lavorato proprio su questo, e gli esempi affiancati pubblicati al lancio mostrano la differenza. Nella spiegazione di un bug di fatturazione, Opus 5 apre con «cosa ho trovato» e una sequenza di frammenti di codice; Opus 5.5 apre con la risposta: il cambio del piano gratuito spiega solo 1,50 $ del calo di agosto, gli altri 9,92 $ vengono da un commit etichettato «nessun cambio di comportamento» che smette di contare l'ultimo giorno del mese. Solo dopo arriva il codice.
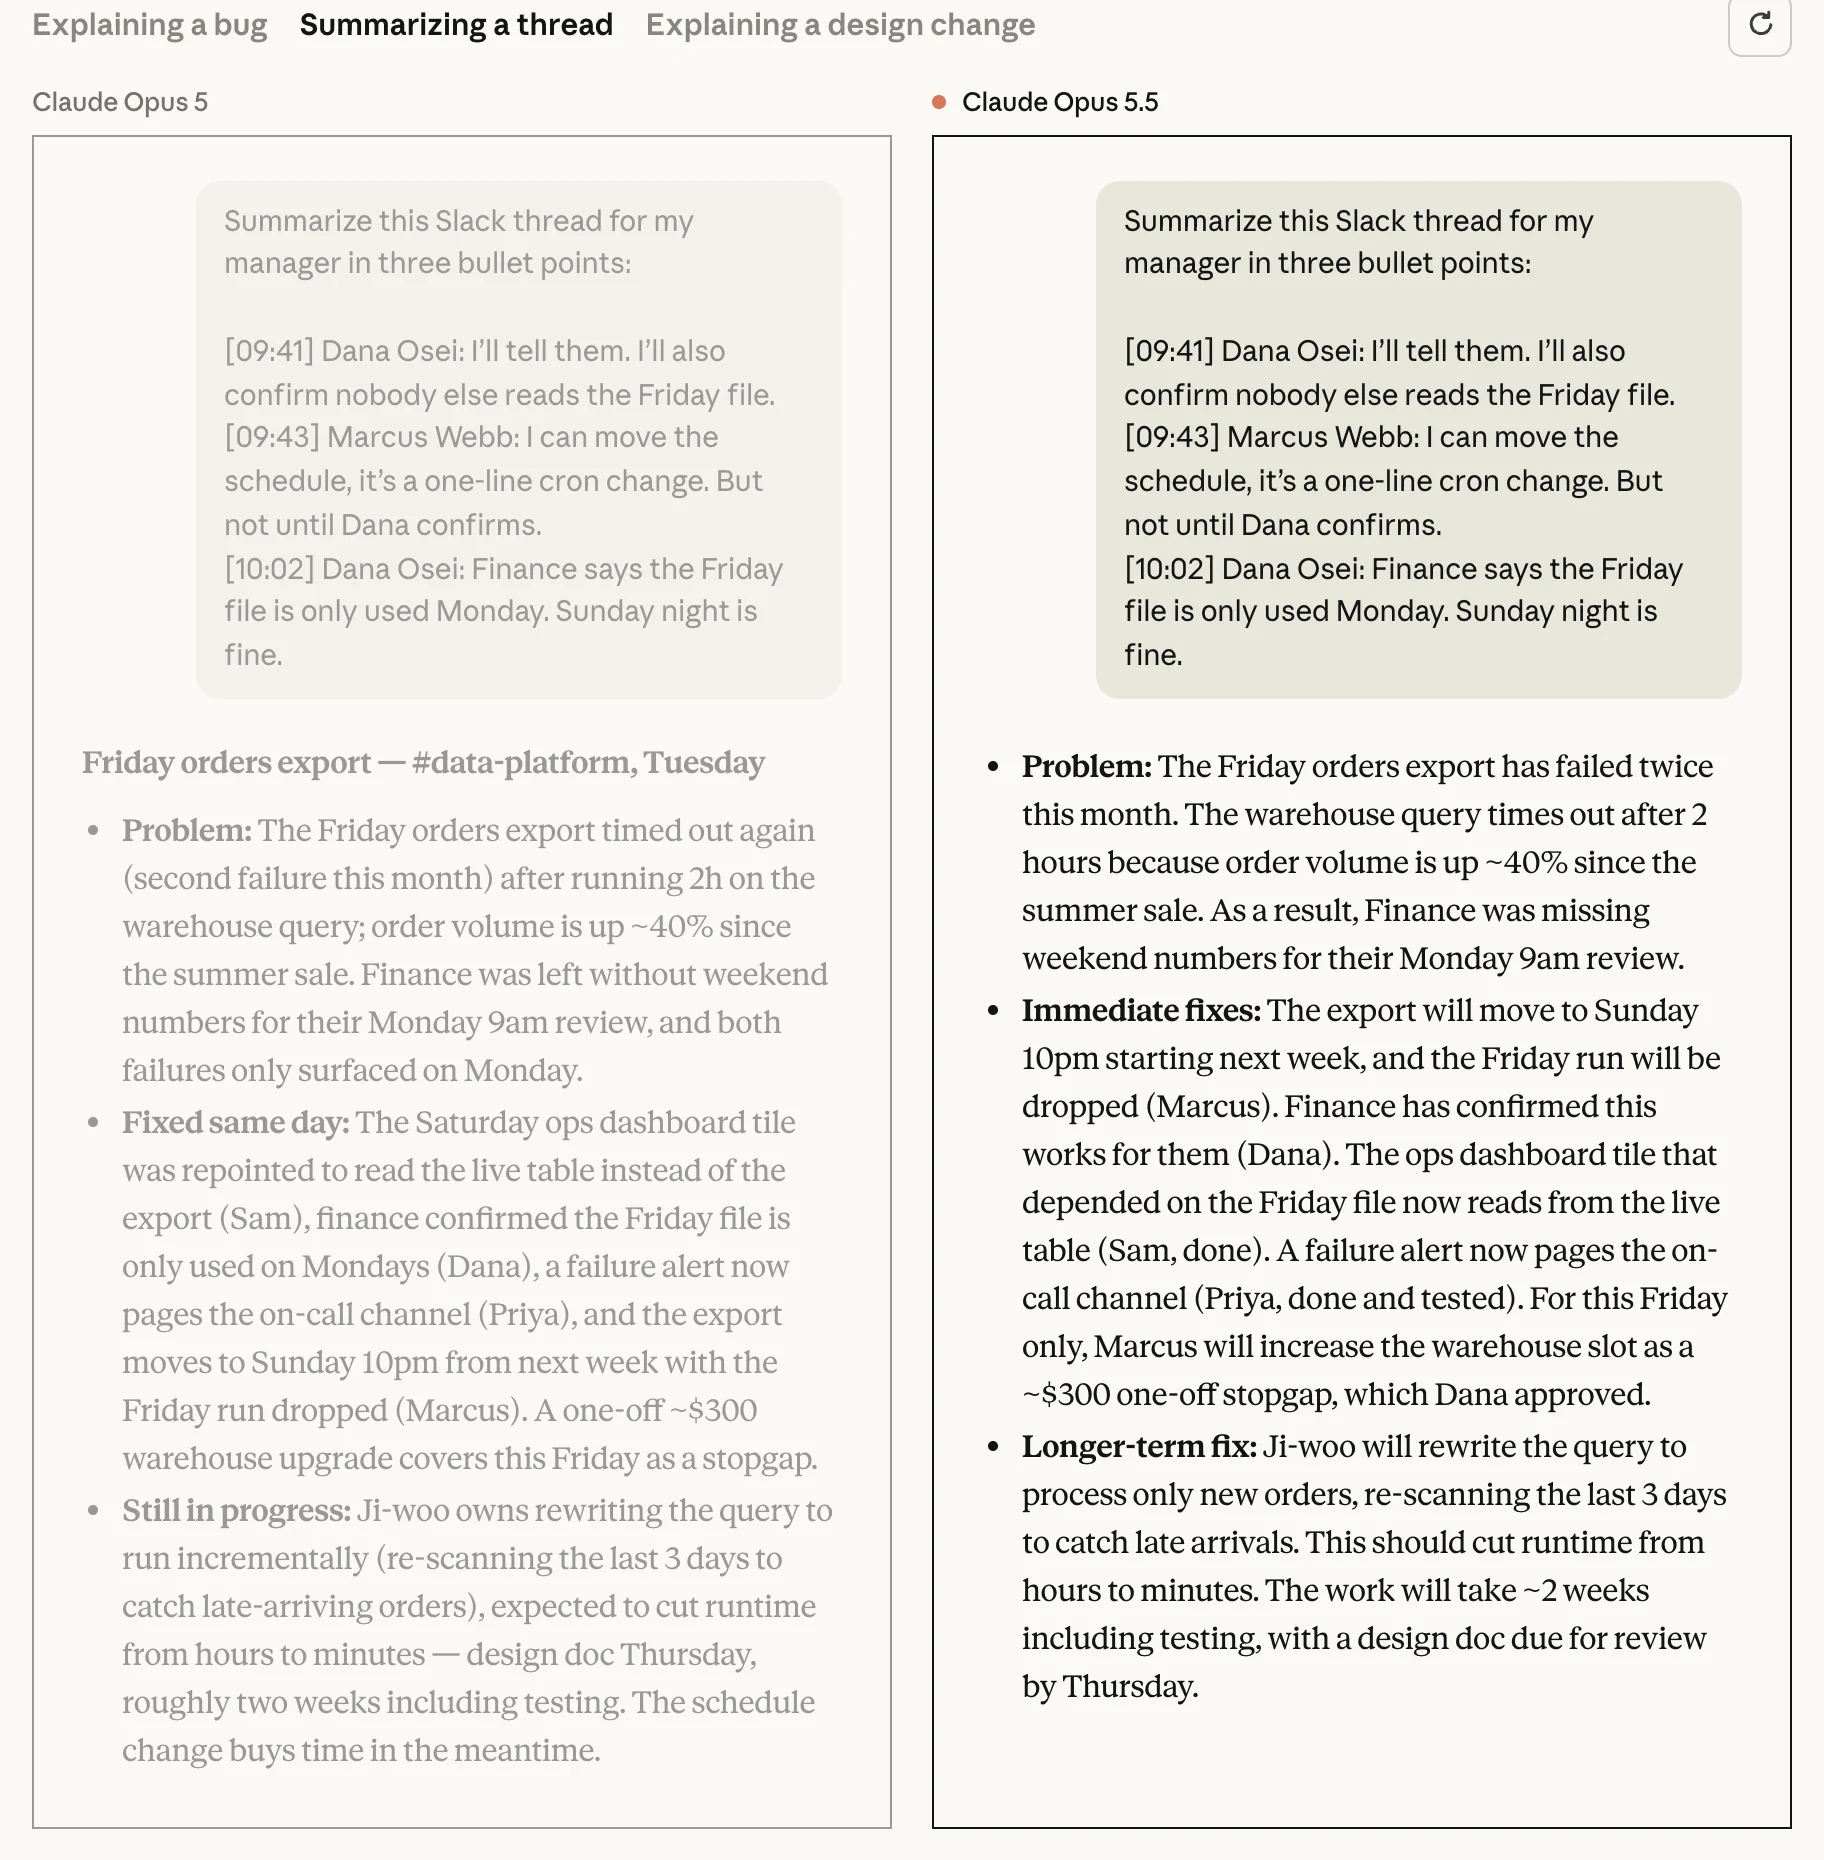
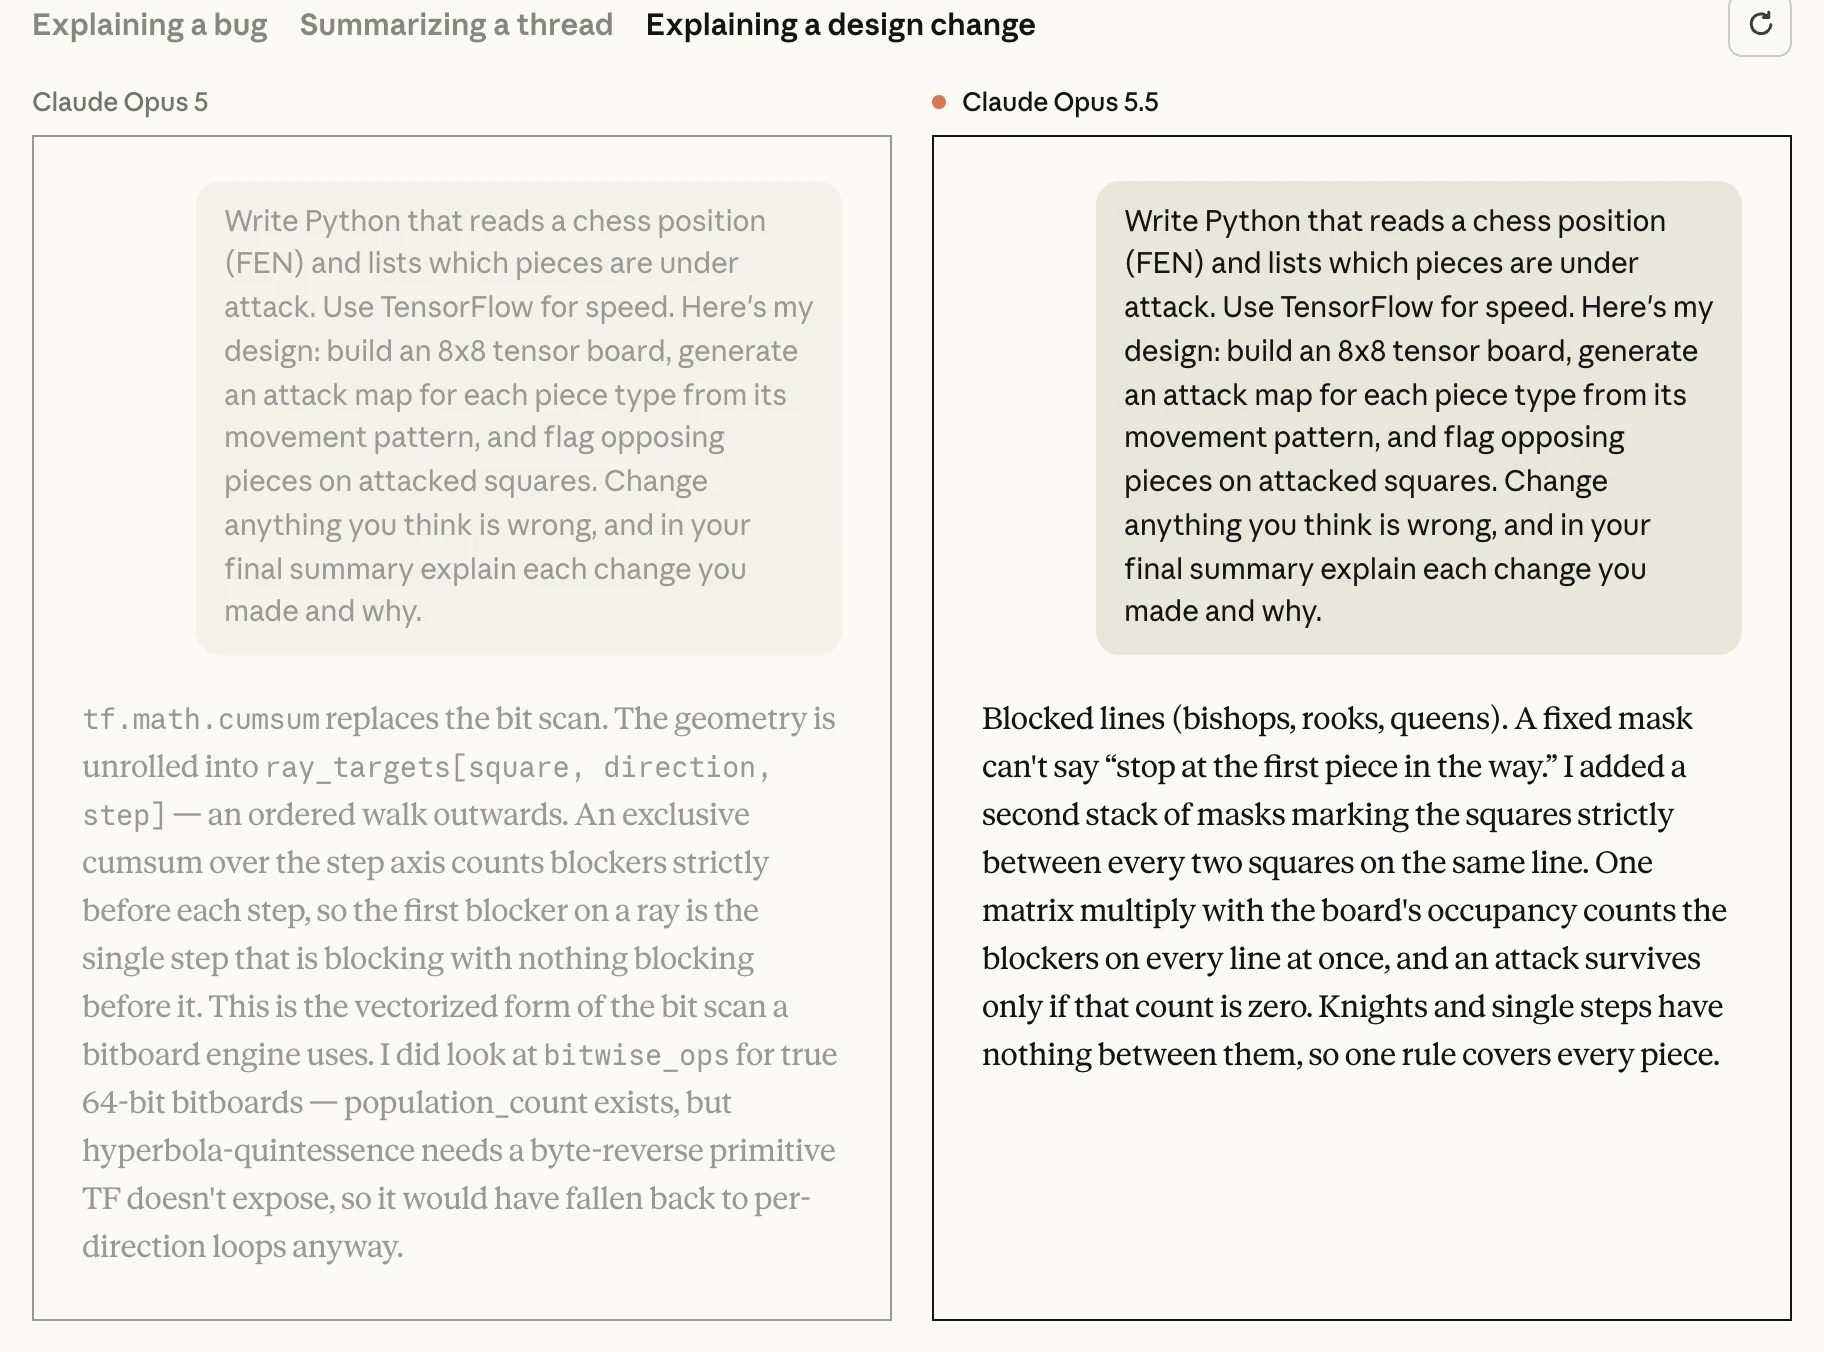
È lo schema che i tester descrivono: l'informazione importante in testa, meno gergo, le regole di stile rispettate. Uno di loro l'ha riassunto così: «scrive come scrivo io». Per chi lavora in sessioni lunghe con un agente non è un dettaglio estetico: un resoconto che si capisce al primo colpo è anche un resoconto che si controlla, e Anthropic lo presenta come un vantaggio di sicurezza oltre che pratico.
Sicurezza: il miglior audit di sempre, con qualche crepa
Opus 5.5 arriva una settimana dopo il saggio in cui Dario Amodei chiede che il progresso dell'AI venga regolato perché le pratiche di sicurezza restino davanti alle capacità. Anthropic dice di lavorare su due orizzonti: pratiche consolidate per i modelli attuali (test di allineamento, valutazioni esterne, salvaguardie commisurate ai rischi) e preparazione per modelli capaci di automatizzare la ricerca sull'AI, per i quali quelle pratiche da sole non basterebbero.
Sull'audit comportamentale automatizzato, circa 2.000 scenari simulati, Opus 5.5 ottiene il risultato migliore di qualunque modello Claude recente su quasi tutte le misure di comportamento disallineato, ed è il più onesto sulla maggior parte delle metriche. In una nuova valutazione sulla tendenza a oltrepassare i confini assegnati, ci ha provato circa l'85% di volte in meno di Opus 5 e Mythos 5.1, e ogni tentativo è stato di bassa gravità e dichiarato dal modello stesso.
La system card, 230 pagine, è però più sfumata dell'annuncio, e vale la pena leggerla:
- in due nuove valutazioni eseguite senza salvaguardie, il modello ha tentato di uscire o manomettere la sandbox nell'1,5% dei casi, e con credenziali apparenti di un registro pubblico di pacchetti ha compiuto azioni potenzialmente dannose in circa metà dei casi di un'esercitazione simulata;
- è più propenso dei modelli precedenti a seguire istruzioni malevole contenute in testo che l'utente incolla nel proprio prompt, e accetta più spesso dichiarazioni di autorizzazione non verificabili;
- spesso sospetta di essere sotto test, e questo rende più difficile prevedere come si comporterà nel mondo reale: Anthropic stessa definisce irrisolto il problema di costruire valutazioni che intercettino ogni errore;
- il monitoraggio non ha trovato sandbagging né inganni strategici di lungo periodo.
Le salvaguardie
Opus 5.5 è il primo Opus a uscire con salvaguardie della stessa classe di Fable 5.1 su cybersecurity, biologia e distillazione, tutte con passaggio trasparente a un altro modello. In pratica:
- Cybersecurity: trovare e correggere bug nel proprio codice resta possibile, ma la maggior parte dei task di sicurezza informatica viene dirottata su Opus 4.8. Chi lavora in difesa potrà accedere tramite il Cyber Verification Program, che nelle prossime settimane includerà Opus 5.5 con tre livelli di accesso fidato, fino ai modelli Mythos.
- Biologia: il modello eguaglia o supera Mythos 5.1 in molte aree e usa le stesse salvaguardie di Fable 5.1. Laboratori accademici, startup e aziende farmaceutiche verificate possono chiedere l'accesso completo con il nuovo Life Sciences Verification Program. La system card lo colloca al livello CB-1 (armi non nuove), non CB-2.
- Distillazione: esce con il preserved thinking introdotto con Fable 5.1, che impedisce di modificare il contesto precedente per estrarre il ragionamento del modello. Vale per gli account API creati dal 31 agosto 2026.
- Dati e conformità: disponibile con zero data retention, e con il watermark testuale che Anthropic applica per rispettare l'AI Act europeo, come già Fable 5.1. Il thinking non si può più disattivare.
Da Opus 5 a Opus 5.5: cosa cambia nel codice
Per chi usa le API, "cambiare solo il nome del modello" non basta. Le note di rilascio elencano quattro breaking change per il codice che gira su Opus 5: il thinking non si può disattivare, il tool use forzato restituisce errore, i blocchi di thinking sono legati al modello e alla conversazione, e su API Claude e Google Cloud il vecchio strumento di computer use non è più accettato. A questi si aggiungono due cambi di comportamento silenziosi: lo sforzo predefinito scende a medium, e il testo che il modello scrive tra una chiamata di strumento e l'altra arriva dentro blocchi di thinking vuoti, quindi un'interfaccia che lo mostrava agli utenti smette di aggiornarsi senza alcun errore.
Il terminale qui sotto ricostruisce i passaggi principali della migrazione, con gli snippet in Python sulla Messages API.
La migrazione passo per passo
La migration guide ufficiale riporta gli stessi passaggi per gli altri SDK (TypeScript, Go, Java, C#, PHP, Ruby) e una checklist completa.
Prezzi, piani e disponibilità
Opus 5.5 è disponibile da oggi sull'API Claude come claude-opus-5-5, su Amazon Bedrock, Claude Platform on AWS, Google Cloud e Microsoft Foundry. Su OpenRouter compare già come anthropic/claude-opus-5.5 allo stesso listino di 4/20 $. La modalità fast (8/40 $) è in anteprima sull'API Claude e in Claude Code, non sui cloud dei partner.
Per gli abbonati alle app Claude, Anthropic alza i limiti d'uso sulle cinque ore per i piani Pro, Max, Team ed Enterprise a postazione, e regala un reset del rate limit da conservare e usare quando serve.
Cosa significa per un'azienda
Per chi costruisce agenti e automazioni, Opus 5.5 sposta il punto di equilibrio. Fino a ieri la scelta era tra Fable 5.1, più capace ma a 10/50 $, e Opus 5 o Sonnet 5 per contenere i costi. Oggi un modello che nella maggior parte dei casi rende come Fable costa meno della metà, e con la cache a 0,20 $ gli agenti che rileggono molto contesto (assistenti su documentazione aziendale, agenti di coding, pipeline su archivi) sono quelli che risparmiano di più.
Tre indicazioni pratiche. Partire da medium e misurare sul proprio carico prima di alzare lo sforzo: i dati di Anthropic dicono che il massimo spesso non ripaga. Preparare la migrazione invece di cambiare solo l'ID: tool_choice forzato e thinking disattivato sono configurazioni comuni nelle integrazioni esistenti. Mettere in conto le salvaguardie: chi lavora in ambito sicurezza informatica o biotech deve passare dai programmi di verifica, altrimenti parte del lavoro finirà su un modello precedente.
Per le aziende europee restano due elementi utili: la zero data retention, che semplifica le valutazioni sul trattamento dei dati, e il watermark legato agli obblighi di trasparenza dell'AI Act sui contenuti generati.
La valutazione di Velthub
Opus 5.5 è il rilascio più pragmatico di Anthropic quest'anno. Non cerca di essere il modello più potente in assoluto, quel ruolo resta a Fable e Mythos, ma porta quasi lo stesso livello a un prezzo da modello di fascia media e con un default che basta nella maggior parte dei casi. I punti deboli sono chiari: i benchmark e i casi d'uso vengono dal produttore e dai clienti in accesso anticipato, la migrazione richiede lavoro, le salvaguardie cyber tolgono di mezzo una parte dei casi d'uso di sicurezza, e la system card documenta regressioni che chi costruisce agenti con accesso a sistemi reali deve considerare. È una valutazione preliminare, basata sulle fonti ufficiali e non su prove Velthub.
Domande frequenti
Quanto costa Claude Opus 5.5?
4 $ per milione di token in input e 20 $ in output, contro 5 e 25 $ di Opus 5. Le letture dalla cache costano 0,20 $, il batch dimezza il prezzo (2/10 $), la modalità fast costa 8/40 $. Secondo Anthropic, sui carichi tipici il costo complessivo scende di circa il 40% rispetto a Opus 5.
Opus 5.5 è meglio di Claude Fable 5.1?
Sui benchmark pubblicati sì, in tutti quelli della tabella: Terminal-Bench 4.0, SWE-bench, CursorBench, OSWorld, GDPval e gli altri. Anthropic stessa però dice che nell'uso reale la distanza è più stretta di quanto dicano i numeri. Il vantaggio concreto di Opus 5.5 è il prezzo: 4/20 $ contro 10/50 $.
Basta cambiare il nome del modello per passare da Opus 5 a Opus 5.5?
Solo se l'integrazione usa già il thinking adattivo e tool_choice automatico. Il thinking disattivato o con budget manuale e il tool use forzato ora restituiscono un errore 400, e su API Claude e Google Cloud il computer use richiede il nuovo toolset. Conviene anche fissare esplicitamente lo sforzo, perché il predefinito è sceso da high a medium.
Quando arrivano Sonnet 5.5 e Haiku 5.5?
Anthropic li annuncia per le prossime settimane, con molti degli stessi miglioramenti di prestazioni, efficienza e sicurezza. Non c'è ancora una data né un listino.
https://velthub.ai/blog/claude-opus-5-5-benchmark-prezzi-costi-sicurezza